
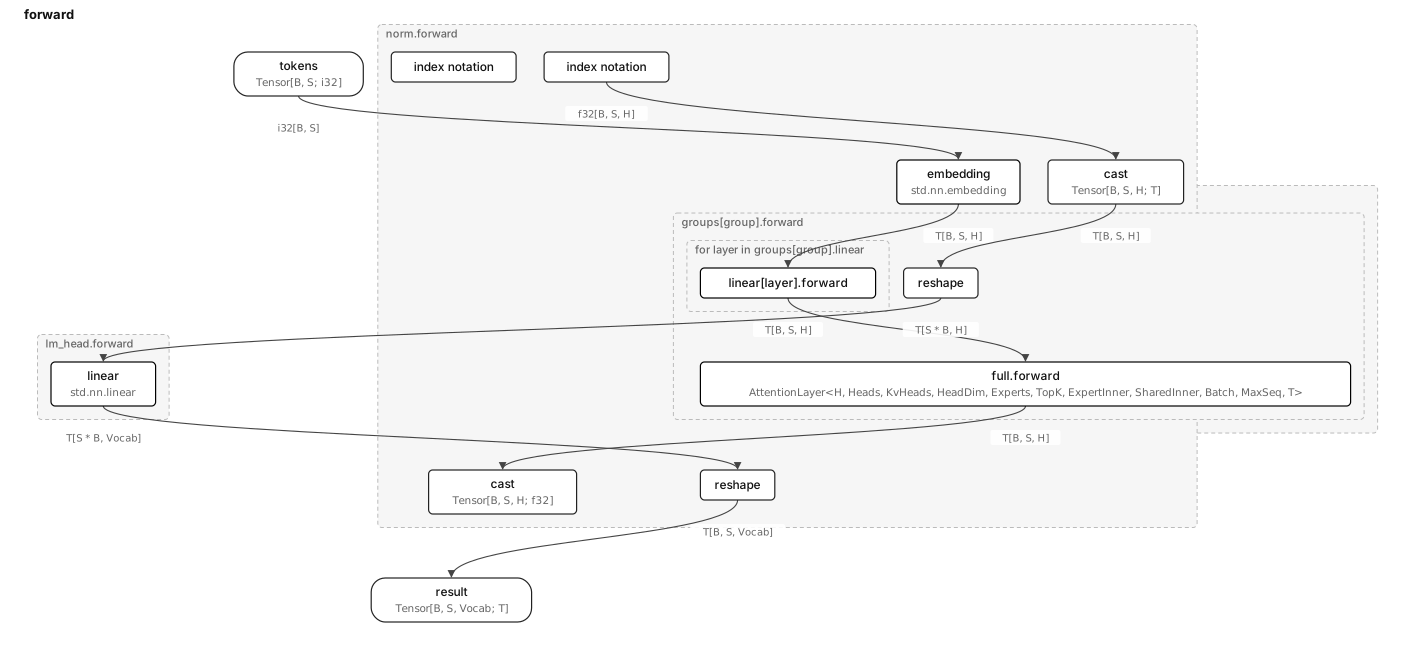
The forward entry with one level of blocks expanded. Every edge carries the tensor type the compiler inferred at that point, in the model's own generics.
Entries
| Entry | Signature |
|---|---|
forward | forward<B: Dim, S: Dim>(tokens: Tensor[B, S; i32]) -> Tensor[B, S, Vocab; T] |
next_token | next_token<B: Dim, S: Dim>(tokens: Tensor[B, S; i32]) -> Tensor[B, Vocab; T] |
decode | decode(token: Tensor[Batch, 1; i32], pos: i32) -> Tensor[Batch, Vocab; T] |
prefill | prefill<S: Dim>(tokens: Tensor[Batch, S; i32], pos: i32) -> Tensor[Batch, Vocab; T] |
decode_rows | decode_rows(tokens: Tensor[Batch, 1; i32], positions: Tensor[Batch; i32]) -> Tensor[Batch, Vocab; T] |
prefill_slots | prefill_slots<M: Dim, S: Dim>(tokens: Tensor[M, S; i32], slots: Tensor[M; i32], lengths: Tensor[M; i32]) -> Tensor[M, Vocab; T] |
Generics
The root block's generics as this checkpoint binds them.
Vocab | 248320 |
H | 2048 |
Heads | 16 |
KvHeads | 2 |
HeadDim | 256 |
KeyHeads | 16 |
ValueHeads | 32 |
KeyDim | 128 |
ValueDim | 128 |
Conv | 8192 |
Width | 4 |
Experts | 256 |
TopK | 8 |
ExpertInner | 512 |
SharedInner | 512 |
Groups | 10 |
Batch | 1 |
MaxSeq | 262144 |
T | bf16 |
Blocks
Every block of the program with its members and functions, as linnet inspect prints them.
AttentionLayer
text
qwen3_5_moe::AttentionLayer<H: Dim, Heads: Dim, KvHeads: Dim, HeadDim: Dim, Experts: Dim, TopK: Dim, ExpertInner: Dim, SharedInner: Dim, Batch: Dim, MaxSeq: Dim, T: Float>
  sub input_layernorm: RmsNorm<H, T>
  sub self_attn: GatedAttention<H, Heads, KvHeads, HeadDim, Batch, MaxSeq, T>
  sub post_attention_layernorm: RmsNorm<H, T>
  sub mlp: SparseMoe<H, Experts, TopK, ExpertInner, SharedInner, T>
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  pub fn decode(x: Tensor[Batch, 1, H; T], pos: i32) -> Tensor[Batch, 1, H; T]
  pub fn prefill<S: Dim>(x: Tensor[Batch, S, H; T], pos: i32) -> Tensor[Batch, S, H; T]
  pub fn decode_rows(x: Tensor[Batch, 1, H; T], positions: Tensor[Batch; i32]) -> Tensor[Batch, 1, H; T]
  pub fn prefill_slots<M: Dim, S: Dim>(x: Tensor[M, S, H; T], slots: Tensor[M; i32]) -> Tensor[M, S, H; T]
  fn feed<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
DeltaLayer
text
qwen3_5_moe::DeltaLayer<H: Dim, KeyHeads: Dim, ValueHeads: Dim, KeyDim: Dim, ValueDim: Dim, Conv: Dim, Width: Dim, Experts: Dim, TopK: Dim, ExpertInner: Dim, SharedInner: Dim, Batch: Dim, T: Float>
  sub input_layernorm: RmsNorm<H, T>
  sub linear_attn: GatedDeltaNet<H, KeyHeads, ValueHeads, KeyDim, ValueDim, Conv, Width, Batch, T>
  sub post_attention_layernorm: RmsNorm<H, T>
  sub mlp: SparseMoe<H, Experts, TopK, ExpertInner, SharedInner, T>
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  pub fn decode(x: Tensor[Batch, 1, H; T]) -> Tensor[Batch, 1, H; T]
  pub fn prefill<S: Dim>(x: Tensor[Batch, S, H; T], pos: i32) -> Tensor[Batch, S, H; T]
  pub fn prefill_slots<M: Dim, S: Dim>(x: Tensor[M, S, H; T], slots: Tensor[M; i32], lengths: Tensor[M; i32]) -> Tensor[M, S, H; T]
  fn feed<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
Embedding
text
std.nn.embedding::Embedding<Vocab: Dim, H: Dim, T: Float = bf16>
  param weight: Tensor[Vocab, H; T]
  pub fn forward<*S: Shape>(ids: Tensor[*S; i32]) -> Tensor[*S, H; T]
GatedAttention
text
qwen3_5_moe.attention::GatedAttention<H: Dim, Heads: Dim, KvHeads: Dim, HeadDim: Dim, Batch: Dim, MaxSeq: Dim, T: Float>
  sub q_proj: Linear<H, 2 * Heads * HeadDim, T>
  sub k_proj: Linear<H, KvHeads * HeadDim, T>
  sub v_proj: Linear<H, KvHeads * HeadDim, T>
  sub o_proj: Linear<Heads * HeadDim, H, T>
  sub q_norm: RmsNorm<HeadDim, T>
  sub k_norm: RmsNorm<HeadDim, T>
  state cache_k: Tensor[Batch, KvHeads, MaxSeq, HeadDim; T]
  state cache_v: Tensor[Batch, KvHeads, MaxSeq, HeadDim; T]
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  pub fn decode(x: Tensor[Batch, 1, H; T], pos: i32) -> Tensor[Batch, 1, H; T]
  pub fn prefill<S: Dim>(x: Tensor[Batch, S, H; T], pos: i32) -> Tensor[Batch, S, H; T]
  pub fn decode_rows(x: Tensor[Batch, 1, H; T], positions: Tensor[Batch; i32]) -> Tensor[Batch, 1, H; T]
  pub fn prefill_slots<M: Dim, S: Dim>(x: Tensor[M, S, H; T], slots: Tensor[M; i32]) -> Tensor[M, S, H; T]
  fn project<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> (Tensor[B, Heads, S, HeadDim; T], Tensor[B, S, Heads * HeadDim; T], Tensor[B, KvHeads, S, HeadDim; T], Tensor[B, KvHeads, S, HeadDim; T])
  fn finish<B: Dim, S: Dim>(mixed: Tensor[B, Heads, S, HeadDim; T], gate: Tensor[B, S, Heads * HeadDim; T]) -> Tensor[B, S, H; T]
  fn rotate<B: Dim, N: Dim, S: Dim>(x: Tensor[B, N, S, HeadDim; T], cos_table: Tensor[S, HeadDim / 4; T], sin_table: Tensor[S, HeadDim / 4; T]) -> Tensor[B, N, S, HeadDim; T]
  fn rotate_rows<B: Dim, N: Dim>(x: Tensor[B, N, 1, HeadDim; T], cos_rows: Tensor[B, 1, HeadDim / 4; T], sin_rows: Tensor[B, 1, HeadDim / 4; T]) -> Tensor[B, N, 1, HeadDim; T]
GatedDeltaNet
text
qwen3_5_moe.deltanet::GatedDeltaNet<H: Dim, KeyHeads: Dim, ValueHeads: Dim, KeyDim: Dim, ValueDim: Dim, Conv: Dim, Width: Dim, Batch: Dim, T: Float>
  sub in_proj_qkv: Linear<H, Conv, T>
  sub in_proj_z: Linear<H, ValueHeads * ValueDim, T>
  sub in_proj_b: Linear<H, ValueHeads, T>
  sub in_proj_a: Linear<H, ValueHeads, T>
  sub norm: GatedRmsNorm<ValueDim, T>
  sub out_proj: Linear<ValueHeads * ValueDim, H, T>
  param conv_weight: Tensor[Conv, 1, Width; T]
  param A_log: Tensor[ValueHeads; T]
  param dt_bias: Tensor[ValueHeads; T]
  state history: Tensor[Batch, 1, -1 + Width, Conv; T]
  state recurrent: Tensor[Batch, ValueHeads, KeyDim, ValueDim; f32]
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  pub fn decode(x: Tensor[Batch, 1, H; T]) -> Tensor[Batch, 1, H; T]
  pub fn prefill<S: Dim>(x: Tensor[Batch, S, H; T], pos: i32) -> Tensor[Batch, S, H; T]
  pub fn prefill_slots<M: Dim, S: Dim>(x: Tensor[M, S, H; T], slots: Tensor[M; i32], lengths: Tensor[M; i32]) -> Tensor[M, S, H; T]
  fn span<B: Dim, S: Dim>(x: Tensor[B, S, H; T], start_history: Tensor[B, -1 + Width, Conv; T], start_state: Tensor[B, ValueHeads, KeyDim, ValueDim; f32], lengths: Tensor[B; i32]) -> (Tensor[B, S, H; T], Tensor[B, -1 + Width, Conv; T], Tensor[B, ValueHeads, KeyDim, ValueDim; f32])
  fn heads<B: Dim, S: Dim>(convolved: Tensor[B, S, Conv; T]) -> (Tensor[B, S, KeyHeads, KeyDim; T], Tensor[B, S, KeyHeads, KeyDim; T], Tensor[B, S, ValueHeads, ValueDim; T])
  fn unit<B: Dim, S: Dim>(x: Tensor[B, S, KeyHeads, KeyDim; T]) -> Tensor[B, S, KeyHeads, KeyDim; T]
  fn gates<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> (Tensor[B, S, ValueHeads; f32], Tensor[B, S, ValueHeads; f32])
  fn finish<B: Dim, S: Dim>(out: Tensor[B, S, ValueHeads, ValueDim; T], x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  fn conv_taps() -> Tensor[Conv, Width; T]
  fn zero_history<B: Dim>() -> Tensor[B, -1 + Width, Conv; T]
  fn zero_state<B: Dim>() -> Tensor[B, ValueHeads, KeyDim, ValueDim; f32]
GatedRmsNorm
text
qwen3_5_moe.norm::GatedRmsNorm<D: Dim, T: Float>
  param weight: Tensor[D; T]
  pub fn forward<*S: Shape>(x: Tensor[*S, D; T], gate: Tensor[*S, D; T]) -> Tensor[*S, D; T]
LayerGroup
text
qwen3_5_moe::LayerGroup<H: Dim, Heads: Dim, KvHeads: Dim, HeadDim: Dim, KeyHeads: Dim, ValueHeads: Dim, KeyDim: Dim, ValueDim: Dim, Conv: Dim, Width: Dim, Experts: Dim, TopK: Dim, ExpertInner: Dim, SharedInner: Dim, Batch: Dim, MaxSeq: Dim, T: Float>
  sub linear: [DeltaLayer<H, KeyHeads, ValueHeads, KeyDim, ValueDim, Conv, Width, Experts, TopK, ExpertInner, SharedInner, Batch, T>; 3]
  sub full: AttentionLayer<H, Heads, KvHeads, HeadDim, Experts, TopK, ExpertInner, SharedInner, Batch, MaxSeq, T>
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  pub fn decode(x: Tensor[Batch, 1, H; T], pos: i32) -> Tensor[Batch, 1, H; T]
  pub fn prefill<S: Dim>(x: Tensor[Batch, S, H; T], pos: i32) -> Tensor[Batch, S, H; T]
  pub fn decode_rows(x: Tensor[Batch, 1, H; T], positions: Tensor[Batch; i32]) -> Tensor[Batch, 1, H; T]
  pub fn prefill_slots<M: Dim, S: Dim>(x: Tensor[M, S, H; T], slots: Tensor[M; i32], lengths: Tensor[M; i32]) -> Tensor[M, S, H; T]
Linear
text
std.nn.linear::Linear<In: Dim, Out: Dim, T: Float = bf16>
  param weight: Tensor[Out, In; T]
  param bias: Tensor[Out; T]?
  pub fn forward<*S: Shape>(x: Tensor[*S, In; T]) -> Tensor[*S, Out; T]
Model
text
qwen3_5_moe::Model<Vocab: Dim, H: Dim, Heads: Dim, KvHeads: Dim, HeadDim: Dim, KeyHeads: Dim, ValueHeads: Dim, KeyDim: Dim, ValueDim: Dim, Conv: Dim, Width: Dim, Experts: Dim, TopK: Dim, ExpertInner: Dim, SharedInner: Dim, Groups: Dim, Batch: Dim, MaxSeq: Dim, T: Float = bf16>
  sub embed_tokens: Embedding<Vocab, H, T>
  sub groups: [LayerGroup<H, Heads, KvHeads, HeadDim, KeyHeads, ValueHeads, KeyDim, ValueDim, Conv, Width, Experts, TopK, ExpertInner, SharedInner, Batch, MaxSeq, T>; Groups]
  sub norm: RmsNorm<H, T>
  sub lm_head: Linear<H, Vocab, T>
  pub entry forward<B: Dim, S: Dim>(tokens: Tensor[B, S; i32]) -> Tensor[B, S, Vocab; T]
  pub entry next_token<B: Dim, S: Dim>(tokens: Tensor[B, S; i32]) -> Tensor[B, Vocab; T]
  pub entry decode(token: Tensor[Batch, 1; i32], pos: i32) -> Tensor[Batch, Vocab; T]
  pub entry prefill<S: Dim>(tokens: Tensor[Batch, S; i32], pos: i32) -> Tensor[Batch, Vocab; T]
  pub entry decode_rows(tokens: Tensor[Batch, 1; i32], positions: Tensor[Batch; i32]) -> Tensor[Batch, Vocab; T]
  pub entry prefill_slots<M: Dim, S: Dim>(tokens: Tensor[M, S; i32], slots: Tensor[M; i32], lengths: Tensor[M; i32]) -> Tensor[M, Vocab; T]
  fn logits<R: Dim>(x: Tensor[R, H; T]) -> Tensor[R, Vocab; T]
  fn hidden_states<B: Dim, S: Dim>(tokens: Tensor[B, S; i32]) -> Tensor[B, S, H; T]
RmsNorm
text
qwen3_5_moe.norm::RmsNorm<H: Dim, T: Float>
  param weight: Tensor[H; T]
  pub fn forward<*S: Shape>(x: Tensor[*S, H; T]) -> Tensor[*S, H; T]
SparseMoe
text
qwen3_5_moe.moe::SparseMoe<H: Dim, Experts: Dim, TopK: Dim, ExpertInner: Dim, SharedInner: Dim, T: Float>
  sub gate: Linear<H, Experts, T>
  param gate_up_proj: Tensor[Experts, 2 * ExpertInner, H; T]
  param down_proj: Tensor[Experts, H, ExpertInner; T]
  sub shared_expert: SwiGlu<H, SharedInner, T>
  sub shared_expert_gate: Linear<H, 1, T>
  pub fn forward<B: Dim, S: Dim>(x: Tensor[B, S, H; T]) -> Tensor[B, S, H; T]
  fn ranks<R: Dim>(logits: Tensor[R, Experts; T]) -> Tensor[R, Experts; i32]
SwiGlu
text
std.nn.mlp::SwiGlu<H: Dim, Inner: Dim, T: Float = bf16>
  sub gate: Linear<H, Inner, T>
  sub up: Linear<H, Inner, T>
  sub down: Linear<Inner, H, T>
  pub fn forward<*S: Shape>(x: Tensor[*S, H; T]) -> Tensor[*S, H; T]